Связный список на Python: Коты в коробках

Python очень удобный и многогранный язык, но по умолчанию не имеет такой структуры данных как связный список или LinkedList. Сегодня я поделюсь своими наработками на эту тему и расскажу немного о том, что из себя представляет эта структура данных. Эта статья будет интересна тем, кто впервые сталкивается с темой связных списков и хочет понять, как они работают с алгоритмической точки зрения.
Что такое LinkedList?
LinkedList или связный список – это структура данных. Связный список обеспечивает возможность создать двунаправленную очередь из каких-либо элементов. Каждый элемент такого списка считается узлом. По факту в узле есть его значение, а также две ссылки – на предыдущий и на последующий узлы. То есть список «связывается» узлами, которые помогают двигаться вверх или вниз по списку. Из-за таких особенностей строения из связного списка можно организовать стек, очередь или двойную очередь.
Давайте визуализируем сухие определения. Теперь у нас есть коты, которые сидят в коробках. И на каждой коробке написано какая она по порядку и за какой должна стоять.

Что мы будем делать со связным списком:
- Проверять содержится ли в нем тот или иной элемент;
- Добавлять узлы в конец;
- Получать значение узла по индексу;
- Удалять узлы.
Начать придется с создания двух классов:
class Box: def __init__ (self,cat = None): self.cat = cat self.nextcat = None class LinkedList: def __init__(self): self.head = NoneВ общем случае, у нас получился узел, у которого есть внутри какое-то значение – кот, и ссылка на следующий узел. То есть в классе Box, соответственно, есть кот и ссылка на следующую коробку. Как и у любого списка, у связного тоже есть начало, а именно head. Поскольку изначально там ничего нет, начальному элементу присваивается значение None.
Содержится ли элемент в списке

Начнем с простого. Чтобы проверить есть ли какой-то определенный кот в одной из последовательно расположенных коробок, нужно пройтись циклом по всему списку, сверяя имеющееся значение со значениями элемента в списке.
def contains (self, cat): lastbox = self.head while (lastbox): if cat == lastbox.cat: return True else: lastbox = lastbox.nextcat return FalseДобавить узел в конец списка

Для начала новую коробку нужно создать, а уже в нее поместить нового кота. После необходимо проверять начиная с начала связного списка, есть ли в текущем узле ссылка на следующий и если она есть, то переходить к нему, в противном случае узел — последний, значит нужно создавать ссылку на следующий узел и помещать в него ту самую новую коробку, которую мы создали.
def addToEnd(self, newcat): newbox = Box(newcat) if self.head is None: self.head = newbox return lastbox = self.head while (lastbox.nextcat): lastbox = lastbox.nextcat lastbox.nextcat = newbox
Получить узел по индексу

По индексу catIndex мы хотим получить узел-коробку, но поскольку как такового индекса у узлов не предусмотрено, нужно придумать какую-то замену, а именно переменную, которая будет выполнять роль индекса. Эта переменная – это boxIndex. Мы проходимся по всему списку и сверяем «порядковый номер» узла, и при совпадении его с искомым индексом – выдаем результат.
def get(self, catIndex): lastbox = self.head boxIndex = 0 while boxIndex
Удалить узел
Здесь мы рассмотрим удаление элемента не по индексу, а по значению, чтобы внести хоть какое-то разнообразие.
Поиск начинается с головы списка, то есть с первой по счету коробки, и продолжается, пока коробки не закончатся, то есть пока headcat не станет None. Мы проверяем соответствует ли значение, хранящееся в текущем узле, тому, которое мы хотим удалить. Если нет, то мы просто идем дальше. Однако, если соответствует, то мы удаляем его и «перепривязываем» ссылки, то есть мы удаляем N-ую коробку, при этом коробка N-1 теперь ссылается на коробку N+1.
def removeBox(self,rmcat): headcat = self.head if headcat is not None: if headcat.cat==rmcat: self.head = headcat.nextcat headcat = None return while headcat is not None: if headcat.cat==rmcat: break lastcat = headcat headcat = headcat.nextcat if headcat == None: return lastcat.nextcat = headcat.nextcat headcat = None
Вот и все, спасибо, что ознакомились с материалом! На самом деле структура LinkedList это не сложно, и важно понимать, как она работает изнутри. Конечно, на Python ее можно было бы реализовать и в lambda-выражениях, это заняло бы гораздо меньше места, однако здесь я преследовала целью объяснить ее строение, и принцип ее работы на Python максимально подробно, а не гнаться за оптимизацией.
- Блог компании OTUS
- Python
- Программирование
16. Связные списки
Мы уже видели примеры атрибутов, которые ссылаются на другие объекты. Ссылки на объекты использует и широко известная структура данных связный список.
Связные списки состоят из узлов, каждый из которых содержит ссылку на следующий узел в списке. Кроме того, каждый узел содержит какие-то полезные данные.
Связный список относится к рекурсивным структурам данных, поскольку его определение рекурсивно.
Связный список представляет собой либо
- пустой список, представленный значением None , либо
- узел, содержащий данные и ссылку на связный список.
Рекурсивные структуры данных могут обрабатываться рекурсивными методами.
16.2. Класс Node 
Как обычно при определении нового класса, мы начнем с инициализирующего метода и метода __str__ , обеспечив возможность создания и отображения объектов нового класса:
class Node: def __init__(self, cargo=None, next=None): self.cargo = cargo self.next = next def __str__(self): return str(self.cargo)
Параметры инициализирующего метода опциональны. По умолчанию и данные, cargo , и ссылка, next , получают значения None .
Строковым представлением узла будет строковое представление данных этого узла. Поскольку функции str можно передать любое значение, в нашем узле можно хранить любое значение.
Для тестирования создадим объект Node и выведем его на печать:
>>> node = Node("test") >>> print node test
Чтобы было интереснее, нам нужен список с более чем одним узлом:
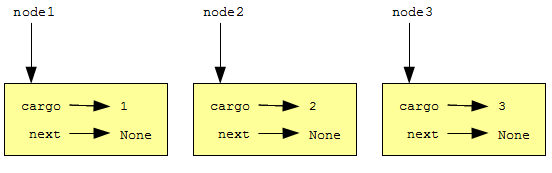
>>> node1 = Node(1) >>> node2 = Node(2) >>> node3 = Node(3)
Этот код создает три узла, но у нас нет списка, так как ни один узел не связан с другим. Посмотрите на рисунок:
Чтобы связать узлы, нам нужно заставить первый узел ссылаться на второй, а второй — на третий:
>>> node1.next = node2 >>> node2.next = node3
Ссылка в третьем узле имеет значение None , что означает конец списка.
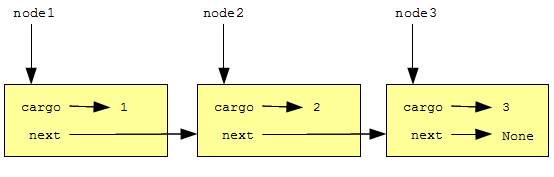
Теперь вы знаете, как создавать узлы и связывать их в списки. Но, возможно, пока не понимаете, зачем это нужно.
16.3. Списки как коллекции
Списки полезны, поскольку дают возможность собрать многочисленные объекты в единую сущность, иногда называемую коллекцией. В примере выше, первый узел списка может служить ссылкой на весь список.
Чтобы передать связный список в качестве аргумента, достаточно передать ссылку на первый узел. Например, функция print_list принимает один узел в качестве аргумента. Начиная с первого узла списка, она выводит на печать каждый узел, пока не достигнет конца списка:
def print_list(node): while node: print node, node = node.next print
Вызовем функцию, передав ей ссылку на первый узел:
>>> print_list(node1) 1 2 3
Хотя у print_list есть ссылка на первый узел списка, внутри функции нет переменных, ссылающихся на другие узлы. Функция получает ссылку на следующий узел, используя значение атрибута next каждого узла.
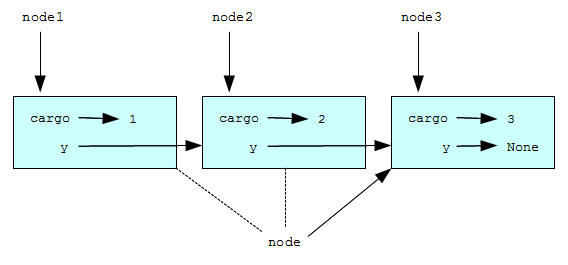
Чтобы пройти весь связный список, обычно используют переменную цикла вроде node , которая последовательно получает значения, ссылающиеся на узлы списка.
16.4. Списки и рекурсия
Многие операции над списком естественно реализовать с помощью рекурсивных методов. Вот рекурсивный алгоритм для вывода на печать списка в обратном порядке:
- Разделить список на две части: первый узел (голова) и все остальные (хвост).
- Распечатать хвост в обратном порядке.
- Распечатать голову.
Разумеется, шаг 2, рекурсивный вызов, предполагает, что у нас имеется способ распечатать список в обратном порядке. Но если мы примем, что рекурсивный вызов работает – нужно в это поверить – то мы можем убедиться в том, что алгоритм работает.
Все, что нам нужно, это простейший случай списка (базовый случай) и доказательство того, что, какой бы список мы ни взяли, наш алгоритм в конце концов приведет нас к этому базовому случаю. Имея рекурсивное определение списка, приведенное выше, в качестве базового случая возьмем пустой список, представленный значением None :
def print_backward(list): if list == None: return head = list tail = list.next print_backward(tail) print head,
Первая строка обрабатывает базовый случай. Две следующие строки кода разделяют список на head (англ.: голова) и tail (англ.: хвост). Две последние строки кода выводят список на печать. Запятая в конце последней строки удерживает Python от перевода строки после печати каждого узла.
Вызовем функцию так же, как вызывали print_list :
>>> print_backward(node1) 3 2 1
В результате на печать выведен список в обратном порядке.
Возможно, вы недоумеваете, почему print_list и print_backward являются функциями, а не методами класса Node . Причина в том, что мы используем None для представления пустого списка, а вызвать метод для None нельзя. Это ограничение не позволяет написать чистый объектно-ориентированный код для манипулирования списком.
Но можем ли мы доказать, что print_backward всегда завершится? Другими словами, всегда ли алгоритм приведет нас к базовому случаю? На самом деле, ответ отрицательный. Некоторые списки сломают наш метод.
16.5. Бесконечные списки
Нет ничего, что помешало бы некоторому узлу ссылаться на узел, который идет в списке раньше этого узла, или ссылаться на самого себя. Например, этот рисунок показывает список с двумя узлами, один из которых ссылается на себя!
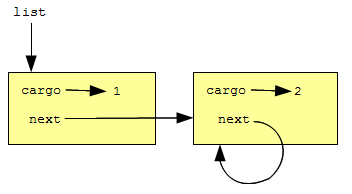
Если вызвать print_list с этим списком, функция зациклится. Если вызвать print_backward , возникнет бесконечная рекурсия. Таким образом, работа с бесконечными списками сопряжена с определенными сложностями.
Тем не менее, иногда бесконечные списки полезны. Например, можно представить число как список цифр, и воспользоваться бесконечным списком для представления дробного периода этого числа.
И все же тот факт, что мы не можем доказать, что print_list и print_backward завершатся, представляет проблему. Лучшее, что мы можем сделать, это выдвинуть гипотезу: Если список не содержит циклов, то эти методы завершатся. Такого рода утверждения называются предусловием. Предусловие налагает ограничение на параметры и описывает поведение функции в случае, когда это ограничение выполняется. Вскоре мы встретимся с другими примерами предусловий.
16.6. Неоднозначность ссылки на узел списка
Следующий фрагмент print_backward может вызвать удивление:
head = list tail = list.next
После выполнения первого предложения присваивания head и list имеют один и тот же тип и одно и то же значение. В таком случае, зачем мы создаем новую переменную?
Причина в том, что эти две переменные играют разные роли. Мы думаем о head как о ссылке на один узел, а о list – как о ссылке на первый узел списка. Эти роли не являются частью программы; они существуют в уме программиста.
В общем случае, глядя на код программы, мы не можем сказать, какую роль играет та или иная переменная. Эта неоднозначность может быть полезной, но также может затруднить чтение программы. Часто, чтобы подчеркнуть роль, которую играет переменная, мы используем переменные с “говорящими” именами, например, node и list , а иногда создаем дополнительные переменные с этой целью.
Можно переписать print_backward без переменных head и tail , что сделает функцию более компактной, но менее ясной:
def print_backward(list) : if list == None : return print_backward(list.next) print list,
Глядя на два вызова функции, нужно помнить, что print_backward рассматривает свой аргумент как коллекцию, а print – как единичный объект.
Если же взять ссылку на узел связного списка вне контекста, то ее семантика неоднозначна. Ссылка на узел связного списка может рассматриваться как ссылка на один узел или как ссылка на список.
16.7. Изменение списков
Можно изменить список двумя способами. Очевидно, что мы можем изменить данные одного из узлов. Но более интересны операции по добавлению, удалению и перестановке узлов.
В качестве примера давайте напишем функцию, которая удаляет второй узел из списка и возвращает ссылку на удаленный узел:
def remove_second(list): if list == None: return first = list second = list.next # make the first node refer to the third first.next = second.next # separate the second node from the rest of the list second.next = None return second
Здесь мы вновь используем временные переменные для того, чтобы сделать код яснее. Воспользуемся этой функцией:
>>> print_list(node1) 1 2 3 >>> removed = remove_second(node1) >>> print_list(removed) 2 >>> print_list(node1) 1 3
Следующий рисунок иллюстрирует результат работы функции remove_second :
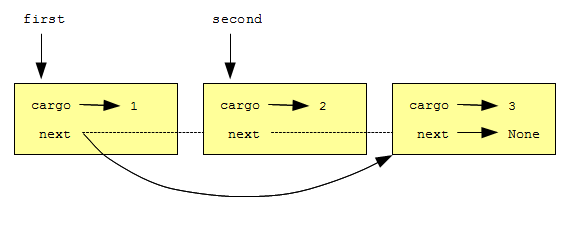
А что случится, если вызвать эту функцию со списком из одного элемента? С пустым списком? Существует ли предусловие для этой функции? Если да, то добавьте в функцию проверку предусловия и обработку его нарушения.
16.8. Обертки и помощники
Если нам понадобится вывести связный список в обратном порядке, заключенный в квадратные скобки, то, как вариант, мы можем воспользоваться функцией print_backward чтобы вывести 3 2 1 , и отдельно вывести открывающую и закрывающую скобки. Назовем новую функцию print_backward_nicely :
def print_backward_nicely(list) : print "[", print_backward(list) print "]",
В любом месте программы можно вызвать функцию print_backward_nicely , а она, в свою очередь, вызовет print_backward . Здесь print_backward_nicely работает как обертка, используя функцию print_backward в качестве помощника.
16.9. Класс LinkedList 
У нашей реализации связных списков есть одна проблема, неочевидная на первый взгляд. Поменяв местами причину и следствие, предложим вначале альтернативную реализацию, а затем рассмотрим, какую проблему она решает.
Создадим новый класс LinkedList . Его атрибутами будут целое число, представляющее длину списка, и ссылка на первый узел списка. С помощью объектов LinkedList удобно манипулировать списками объектов Node :
class LinkedList: def __init__(self): self.length = 0 self.head = None
Класс LinkedList оказывается удобным местом для помещения в него таких функций, как print_backward_nicely , и превращения их в методы этого класса:
class LinkedList: . def print_backward(self): print "[", if self.head != None: self.head.print_backward() print "]", class Node: . def print_backward(self): if self.next != None: tail = self.next tail.print_backward() print self.cargo,
Мы переименовали print_backward_nicely , и теперь у нас два метода с именами print_backward : один в классе Node (помощник), и один в классе LinkedList (обертка). Когда метод-обертка вызывает self.head.print_backward , он вызывает метод-помощник, поскольку self.head ссылается на объект Node .
Еще один плюс класса LinkedList состоит в том, что он облегчает добавление и удаление первого элемента списка. Например, следующий метод add_first класса LinkedList принимает в качестве аргумента данные для узла и помещает новый узел с этими данными в начало списка:
class LinkedList: . def add_first(self, cargo): node = Node(cargo) node.next = self.head self.head = node self.length += 1
Создадим связный список, добавим в него три узла и выведем его на печать в обратном порядке:
>>> linkedlist = LinkedList() >>> linkedlist.add_first(1) >>> linkedlist.add_first(2) >>> linkedlist.add_first(3) >>> linkedlist.print_backward() [ 1 2 3 ]
Поскольку каждый раз новый узел добавляется в начало списка, то последовательно добавленные нами узлы со значениями 1 , 2 , 3 расположились в обратном порядке, и метод print_backward вывел узлы в порядке их добавления.
В качестве упражнений вам будет предложено добавить другие полезные методы в класс LinkedList и поэкспериментировать с ними.
16.10. Инварианты
Некоторые списки построены правильно; другие нет. Например, если список содержит цикл, он сломает многие из наших методов. Поэтому мы можем потребовать, чтобы списки не содержали циклов. Другое разумное требование состоит в том, чтобы значение length в объекте LinkedList всегда равнялось реальному числу узлов в списке.
Требования, подобные этим, называются инвариантами, поскольку, в идеале, они должны выполняться для каждого объекта в любой момент времени. Указание инвариантов для объектов — полезный прием программирования. Он облегчает доказательство корректности кода, проверку целостности структур данных, и способствует обнаружению ошибок.
Заметим, что в отдельные моменты времени инварианты все же не выполняются. Например, в середине метода addFirst , после того, как мы добавили узел, но перед тем, как мы увеличили length , инвариант оказывается нарушенным. Такого рода нарушение приемлемо; действительно, часто невозможно изменить объект, не нарушая инвариант хотя бы ненадолго. Достаточно потребовать, чтобы метод, который нарушает инвариант, восстанавливал его.
Если имеется значительный участок кода, в котором инвариант нарушен, важно отразить это в комментариях. Чтобы операции, зависящие от инварианта, не выполнялись, пока инвариант не восстановлен.
16.11. Глоссарий
инвариант Утверждение, которое должно выполняться для объекта в любое время (за исключением того времени, когда объект изменяется). обертка Метод, который выступает посредником между вызывающим кодом и методом-помощником; способствует упрощению и повышению надежности кода. помощник Метод, не вызываемый непосредственно, а используемый вызываемым методом для выполнения части работы. предусловие Утверждение, которое должно быть справедливым, для того чтобы функция выполнялась корректно. связный список Структура данных, реализующая коллекцию, используя последовательность связанных узлов. узел списка Элемент списка, обычно реализуемый как объект, содержащий ссылку на объект того же типа и некоторые полезные данные.
16.12. Упражнения
- Традиционно списки выводятся на печать в скобках, с запятыми между элементами, например: [1, 2, 3] . Добавьте в класс LinkedList метод print_list так, чтобы он возвращал список в таком формате.
- Добавьте в класс LinkedList метод last , который вернет последний узел в списке или None в случае, когда список пуст. Протестируйте работу метода для пустого и непустого списков.
- Добавьте в класс LinkedList метод append(self, cargo) для добавления узла в конец списка. Используйте метод list из предыдущего упражнения для получения узла, к которому будет добавляться новый узел. Протестируйте работу метода.
- Добавьте в класс LinkedList метод find(self, cargo) для поиска в списке узла с cargo , ближайшего к началу списка. Протестируйте метод для пустого списка, списка, содержащего узел с искомым cargo , и для списка, не содержащего такого узла.
- Добавьте в класс LinkedList метод __contains__(self, cargo) чтобы реализовать оператор in для LinkedList . Используйте метод find из предыдущего упражнения в методе __contains__ . Протестируйте работу оператора in для пустого списка, списка, содержащего узел с cargo , и списка, не содержащего такого узла.
Просмотр
© Copyright 2009, 2012, Джеффри Элкнер, Аллен Б. Дауни, Крис Мейерс, Андрей Трофимов. При создании использован Sphinx 1.1.3.
Связный список на Python: что это такое и как его реализовать
Давайте поговорим немного о связных списках. Вероятно, вы о них слышали. Скажем, на лекциях по структурам данных. И возможно, вы думали, что это как-то сильно заумно. Почему бы не использовать массив? На самом деле связные списки имеют некоторые преимущества перед массивами и простыми списками. Поначалу эта тема может показаться сложной, но не волнуйтесь: мы все разберем.
Если вы представите себе фотографию людей, взявшихся за руки в хороводе, вы получите примерное представление о такой структуре, как связный список. Это некоторое количество отдельных узлов, связанных между собой ссылками, т. е. ссылками на другие узлы. Связные списки бывают двух видов: однонаправленные и двунаправленные (односвязные и двусвязные).
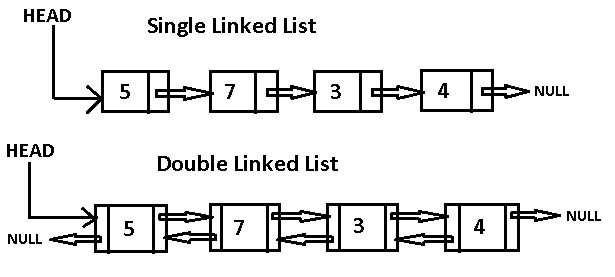
В односвязных списках каждый узел имеет одну стрелку, указывающую вперед, а в двусвязных узлы имеют еще и стрелки, указывающие назад. Но на собеседованиях в вопросах, касающихся связных списков, чаще всего имеются в виду односвязные. Почему? Их проще реализовать. Да, у вас не будет возможности перемещаться по списку в обратном направлении, но для отслеживания узлов хватит и однонаправленных связей.
Давайте попробуем реализовать связный список на Python. Возможно, вы бы начали с class Linked_list , а затем создали в нем узлы, но все можно сделать куда проще. Представьте цепочку из скрепок. Мы берем кучку скрепок и соединяем их, цепляя друг за дружку.
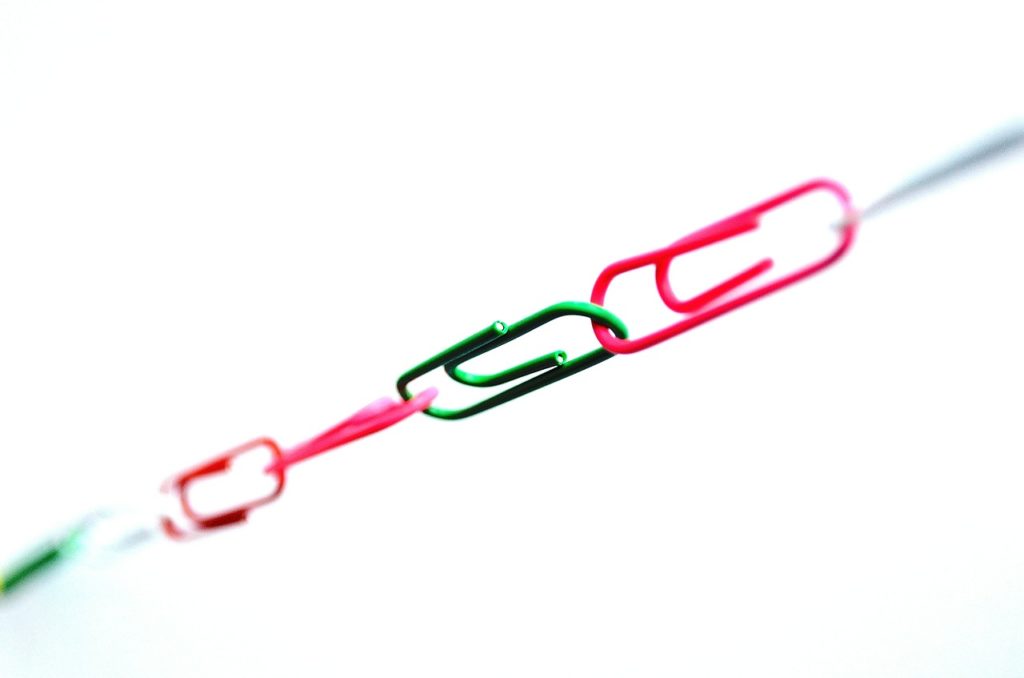
Цепочку создают отдельные скрепки плюс тот факт, что они сцеплены между собой. Поэтому вместо создания класса Linked_list мы просто создадим класс Node и позволим отдельным узлам связываться друг с другом.
class Node:
Далее, как обычно при создании класса на Python, мы создаем метод __init__ . Этот метод инициализирует все поля, например, переменные в классе, при создании каждого нового объекта Node .
Мы будем принимать переменную data — это значение, которое мы хотим сохранять в узле. Также нам нужно определить ссылку, направленную вперед, она традиционно называется next . Сначала узел не связан ни с чем, поэтому мы устанавливаем next в None .
class Node: def __init__(self, data): self.data = data self.next = None
Это почти все, что нам нужно. Можно оставить, как есть, но в книге «Cracking the Coding Interview» также реализуется метод appendToTail() , который создает новый узел и добавляет его в конец списка, проходя его, так что нам не приходится делать это вручную.
Начнем с определения этого метода в классе Node . Метод будет принимать значение, которое мы хотим поместить в новый узел, и ключевое слово self (это специфично для Python).
class Node: def __init__(self, data): self.data = data self.next = None def append(self, val): pass
Первое, что мы делаем, это создаем новый узел с заданным значением. Назовем его end .
def append(self, val): end = Node(val)
Затем мы создаем указатель (поинтер). Это может звучать слишком технически, но по сути мы создаем ссылку на головной элемент ( head ) нашего списка. Мы делаем так, потому что хотим проходить по списку, не переназначая в нем ничего. Итак, мы делаем ссылку на первый узел, self , и сохраняем его в переменной n .
def append(self, val): end = Node(val) n = self
Наконец, мы проходим список. Как мы это делаем? Нам нужно всего лишь перемещаться к следующему узлу, если он есть. А если следующего узла нет, мы поймем, что мы уже в конце списка. Для прохождения списка до предпоследнего узла мы используем простой цикл while .
def append(self, val): end = Node(val) n = self while (n.next): n = n.next
Наконец, мы указываем на последний узел, за которым нет следующего узла. Мы просто берем end — наш новый узел — и устанавливаем n.next = end .
def append(self, val): end = Node(val) n = self while (n.next): n = n.next n.next = end
Вот и все! Вот как выглядит наш класс полностью:
class Node: def __init__(self, data): self.next = None self.data = data def append(self, val): end = Node(val) n = self while (n.next): n = n.next n.next = end
Проверяем наш связный список
Давайте все это проверим. Начнем с создания нового объекта Node. Назовем его ll (две латинские буквы «l» в нижнем регистре как сокращение Linked List). Назначим ему значение 1.
ll = Node(1)
Поскольку мы написали такой классный метод append() , мы можем вызывать его для добавления в наш список новых узлов.
ll.append(2) ll.append(3)
Как нам увидеть, как выглядит наш список? Теоретически, выглядеть он должен следующим образом:
[1] --> [2] --> [3]
Но нет способа вывести его именно в таком виде. Нам нужно пройти список, выводя каждое значение. Вы же помните, как проходить список? Мы только что это делали. Повторим:
- Создаем переменную, указывающую на head .
- Если есть следующий узел, перемещаемся к этому узлу.
И просто выводим data в каждом узле. Мы начинаем с шага № 1: создаем новую переменную и назначаем ее головным элементом списка.
node = ll
Далее мы выводим первый узел. Почему мы не начали с цикла while? Цикл while проитерируется только дважды, потому что только у двух узлов есть next (у последнего узла его нет). В информатике это называется ошибкой на единицу (когда нужно сделать что-то Х раз плюс 1). Это можно представить в виде забора. Вы ставите столб, затем секцию забора, и чередуете пару столб + секция столько раз, сколько нужно по длине.
Но вы не можете оставить последнюю секцию забора висящей в воздухе. Ограда должна закончиться столбом, а не секцией. Поэтому вам приходится либо добавлять еще один столб в конце, либо (что в информатике более распространено) начать с постановки столба, а затем добавлять пары секция + столб . Это мы и сделаем.
Для начала мы выведем первый узел, а затем запустим цикл while для вывода всех последующих узлов.
node = ll print(node.data) while node.next: node = node.next print(node.data)
Запустив это для нашего предыдущего списка, мы получим в консоли:
1 2 3
Ура! Наш связный список работает.
Зачем уметь создавать связный список на Python?
Зачем вообще может понадобиться создавать собственный связный список на Python? Это хороший вопрос. Использование связных списков имеет некоторые преимущества по сравнению с использованием просто списков Python.
Традиционно вопрос звучит как «чем использование связного списка лучше использования массива». Основная идея в том, что массивы в Java и других ООП-языках имеют фиксированный размер, поэтому для добавления элемента приходится создавать новый массив с размером N + 1 и помещать в него все значения из предыдущего массива. Пространственная и временная сложность этой операции — O(N). А вот добавление элемента в конец связного списка имеет постоянную временную сложность (O(1)).
Списки в Python это не настоящие массивы, а скорее реализация динамического массива, что имеет свои преимущества и недостатки. В Википедии есть таблица со сравнением производительности связных списков, массивов и динамических массивов.
Если вопрос производительности вас не тревожит, тогда да, проще реализовать обычный список Python. Но научиться реализовывать собственный связный список все равно полезно. Это как изучение математики: у нас есть калькуляторы, но основные концепции мы все-таки изучаем.
В сообществе разработчиков постоянно ведутся горячие споры о том, насколько целесообразно давать на технических интервью задания, связанные с алгоритмами и структурами данных. Возможно, в этом и нет никакого смысла, но на собеседовании вас вполне могут попросить реализовать связный список на Python. И теперь вы знаете, как это сделать.
Связанные списки в Python
Связанный список - это линейная структура данных, элементы которой не хранятся в непрерывном месте. Это означает, что связанный список содержит отдельные вакуоли, известные как «узлы», которые содержат данные, для которых они были созданы, и ссылку на другой узел в списке.
Некоторыми преимуществами связного списка являются его прерывистый характер и время чтения, никогда не превышающее O(n). Связанный список не нужно хранить постоянно, потому что он имеет ссылки, встроенные в каждый узел, для расположения следующего по порядку. Если в памяти вашего компьютера мало места, идеально подойдет связанный список, поскольку всю структуру не нужно хранить в одном месте. Это также означает, что чтение связанного списка является линейным, поскольку размер списка приближается к бесконечности.
Однако недостатки делают его особенным. Кроме того, если в список вносится добавление, необходимо обновить весь список, чтобы ссылки оставались правильными. Последовательный характер связанного списка означает, что произвольный доступ не разрешен. Каждый узел необходимо читать в том порядке, в котором он был создан, чтобы иметь доступ ко всей необходимой информации.
В этой статье мы рассмотрим концепцию единственных и двусвязных списков и некоторые общие вопросы интервью, которые могут появиться для каждого из них.
Односвязный список
Односвязный список состоит из нескольких узлов, каждый из которых содержит а) данные и б) ссылку на следующий узел.

На изображении выше мы видим макет связанного списка. Начиная слева и продвигаясь вправо, мы видим, что заголовок списка содержит данные и указатель на следующий узел. Этот шаблон продолжается до конца списка, где он не является узлом. Значение NULL означает, что список закончился.
Посмотрите ниже код для создания односвязного списка.
# Node class class Node: # Function to initialize the node object def __init__(self, data): self.data = data # Assign data self.nextnode = None # Initialize next as null a = Node(1) # declaring data in each node b = Node(2) c = Node(3) a.nextnode = b # link first node to second node b.nextnode = c # link second node to third node a.next.value # will return the value of the next node b = 2 Двусвязный список
В двусвязном списке каждый узел содержит данные, ссылку на узел, после него, и ссылку на узел, предшествующий ему.

Разница между односвязным списком и двусвязным списком - это «предыдущие» стрелки, указанные на рисунке выше. Преимущества дополнительного указателя означают, что список можно перемещать в любом направлении при доступе к информации - это означает, что переход от узла 5 к узлу 8 может быть проще, чем обход с начала списка.
Новые узлы в начале и в конце списка называются «дозорными». Эти узлы заменяют значения NULL, которые вы видите выше. Они позволяют быстро вставлять или удалять вверху или внизу списка.
Посмотрите ниже код для двусвязного списка.
# Code to create the nodes for a doubly linked list # A linked list node class Node: def __init__(self): self.data = None # container of the data self.next_node = None # standard pointer to next node self.prev_node = None # pointer to previous node # Creating each node a = Node(1) b = Node(2) c = Node(3) # Connect the nodes # Connect nodes a & b to each other in both directions a.next_node = b b.prev_node = a # Connect nodes b & c to each other in both directions b.next_node = c c.prev_node = b """ We could create a circularly linked list by connecting the head of the list to the tail """ Теперь, когда у нас есть код, необходимый для создания связанных списков, давайте рассмотрим некоторые общие вопросы собеседования, варианты которых вы можете найти на Leetcode.
Вопросов
1. Сторнирование связанного списка
Создайте функцию, чтобы перевернуть связанный список на месте. Вы будете использовать заголовок исходного списка и возвращать заголовок перевернутого списка.
Уловка, стоящая за этой проблемой, заключается в том, что разворот должен происходить в постоянном пространстве. Поэтому мы не создаем новый список и не добавляем или не используем прокси. Это необходимо сделать, работая непосредственно с этим списком.
def reversal(head): # set variables for the node position current = head # prev = None next_node = None # let's us know that we haven't reached the end of the list while current: # copy the pointer of the head before we override it next_node = current.nextnode # change the pointer to point at None (because it is the new tail) current.nextnode = prev # move us along on the list, current becomes previous prev = current # and the next node becomes the current node we are looking at current = nextnode return prev Как объяснено в приведенном выше коде, мы, по сути, просто переключаем указатели для каждого узла. Входными данными является текущая глава связанного списка - или в наших примерах. Затем функция проходит через каждый узел и переключает направление атрибута nextnode. Посмотрите картинку ниже для дальнейшей визуализации.

Этот подход имеет то преимущество, что снижает затраты на память и впечатляет интервьюеров своей способностью работать без создания нового списка и удержания процесса на O(n) времени.
2. Связанный список с N-го до последнего узла
Создайте функцию, которая принимает головной узел и целое число n, а затем возвращает n-й и последний узел из списка.
Уловка для этой задачи состоит в том, чтобы пройти по списку двумя маркерами. Первый маркер выполняет итерацию и проверяет, действительно ли существует предпоследний узел. Второй маркер идет позади и заканчивается в этом узле.
def nth_last_node(n,head): # create two pointers that both start at the head of the list pointer_1 = head pointer_2 = head # we will iterate through the list, moving the right pointer # until there are n-spaces between them for i in range(n-1): # edge case, if no nextnode, raise an error if not pointer_1.nextnode: raise LookupError('Error: Command continues past index of list') # if not edge case, move the right pointer to next node pointer_1 = pointer_1.nextnode # now there is a n-size block between them # as long as the right pointer does not reach the end of the list # the left pointer will move while pointer_1.nextnode: # once the right pointer hits the end the left pointer has found the # nth to last node from the end pointer_2 = pointer_2.nextnode pointer_1 = pointer_1.nextnode # return the nth to last node return pointer_2 Хотя код отлично справляется с созданием пространства между ними, давайте посмотрим на визуальный элемент.

Как вы можете видеть между первым и вторым шагами, идея состоит в том, что указатель 1 должен создавать расстояние между собой и указателем 2, равное n узлам. Как только это безопасно, два указателя могут перемещаться в унисон - указатель 1 проверяет, не закончился ли список, и указатель 2 готов к объявлению своей текущей позиции как n-го до последнего узла.
Вот и все. У нас были базовые основы того, что такое связанный список, и какие вопросы по нему можно задать.